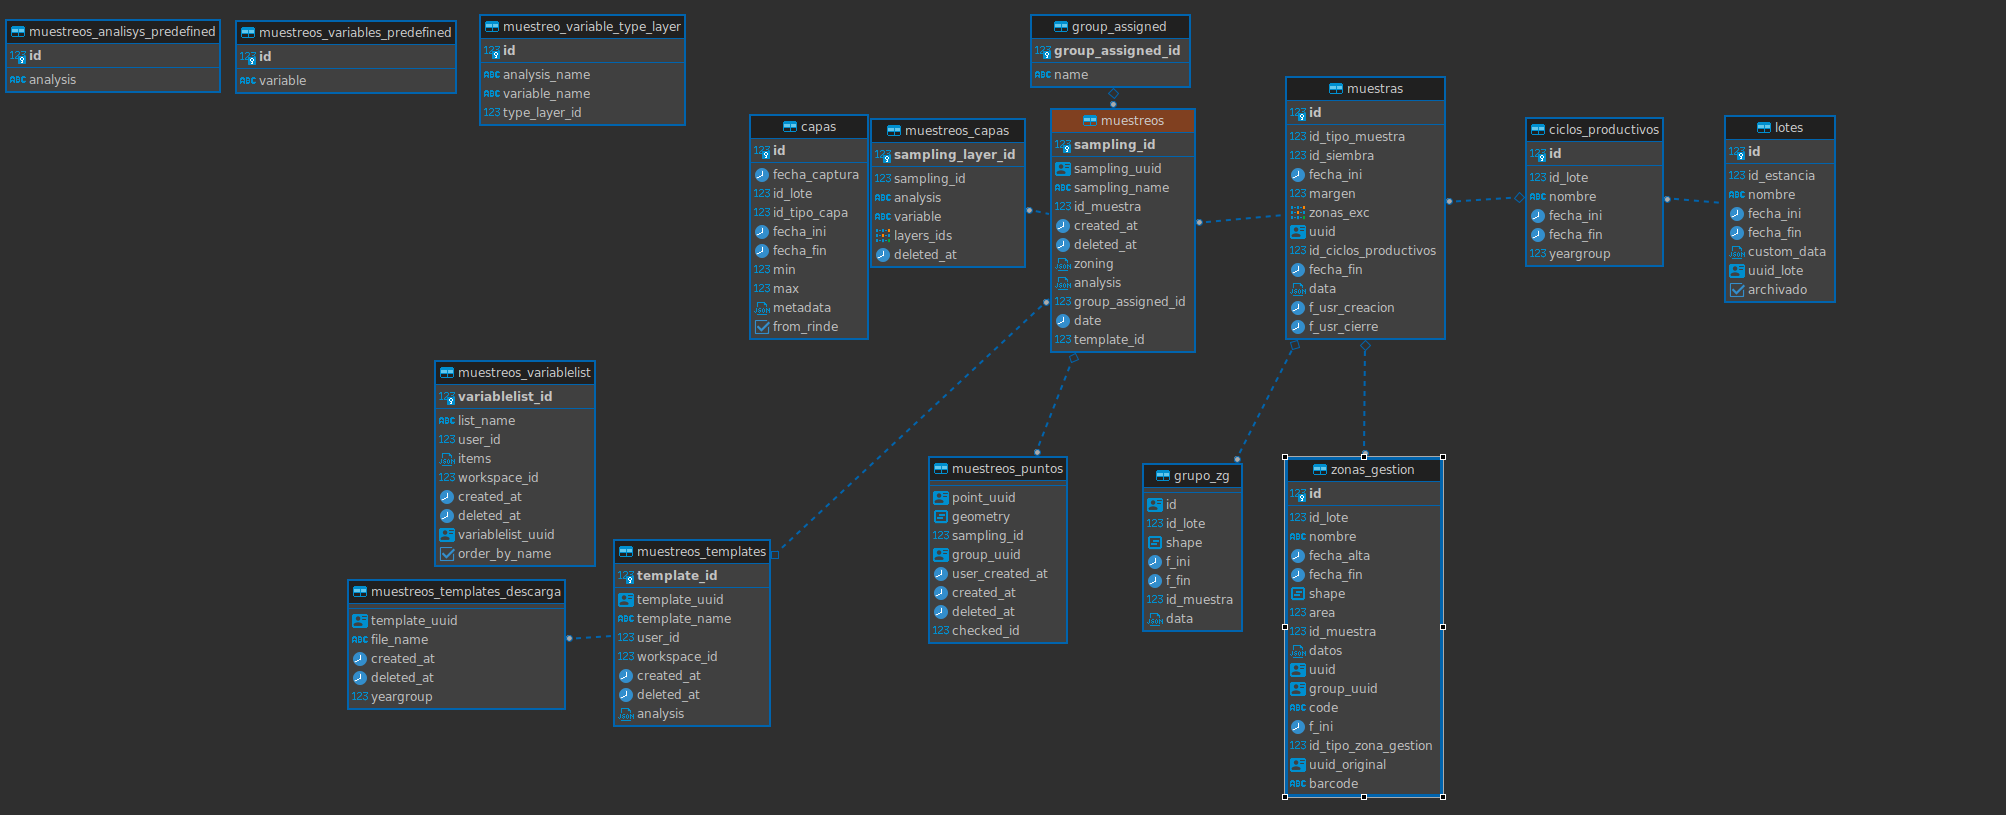
Muestreos-db
Muestreos
Tablas principales
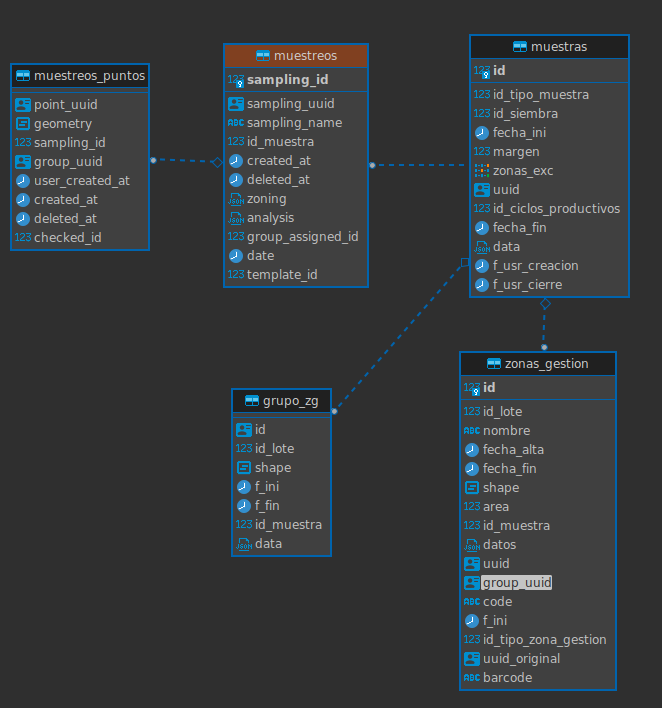
muestreos
- sampling_id
- sampling_uuid
- sampling_name
- id_muestra
- created_at: Fecha de insert en la base
- deleted_at
- zoning: Puede ser un mapa o una layer
{"type": "map", "info": {"map_id": $map_id}}{"type": "layer", "info": {"provider": $layer_name, "operation": $operation, "date": $layer_date(ej:"02 11 2022"), "hour": $layer_time(ej:"17:19:36")} }
- analysis: key del json es el nombre del analisis, el valor es un array de
{"name": $var_name, "unit_id": $unit_id}. (Estas son las keys obligatorias tambien puede tener "list_uuid", "max_value", "min_value"), se detalla sobre esto en template - group_assigned_id: la forma que fueron asigndados los grupos ('Sin asignar', 'Independiente', 'Poligono', 'Ambiente')
- date: Fecha del muestreo
- template_id: Si se creo apartir de un template (solo queda la referencia para saber desde que template se creo, sirve en la descarga masiva)
muestreos_puntos
- point_uuid
- geometry
- sampling_id
- group_uuid:
- Relaciona el punto con zonas_gestion (aca es donde se guarda los valores de las variables)
- Tambien nos permite agrupar puntos para tomar una sola muestra por el conjunto de puntos
- user_created_at: para mobile, fecha de creacion del punto (sirve si esta offline)
- created_at: fecha insert db
- deleted_at
- checked_id: ('No Checked', 'Checked', 'Checked con GPS'), si es con gps se hizo con mobile cerca del punto
grupo_zg
- id
- id_lote
- shape: siempre es null
- f_ini
- f_fin
- id_muestra
- data: color y nombre del grupo ej:
{"sampling": {"color": "#647C80", "name": "6"}}
zonas_gestion
Cada zona de gestion es un analisis de un grupo
- id
- id_lote
- id_muestra
- datos: las variables de un analisis,
{"sampling": {"analysis": $analisis_name}, "variables": \[{"name": $var_name, "unit_id": $unit_id, "value": $value}\]} - uuid
- group_uuid
- code: Se crea de una forma que sean similares entre si(esto por marcadores), es el codigo que se muestra por analisis.
- barcode: Este fue creado para agd, es el codigo de laboratorio
- fecha_alta
- fecha_fin
- f_ini
*No se usan en muestreos
- nombre
- shape: Deberia ser null, pero hay valores que son iguales que los puntos. Esto se rompe cuando se agrupan puntos ⚠️️ Warning: No tener en cuenta este valor
- area
- id_tipo_zona_gestion
- uuid_original
muestras
Lo que nos importa de aca es id_ciclo_productos
id_tipo_muestra, siempre es 3(muestreos)
querys
Query para traer muestreos y sus puntos (Esto no trae los valores de las variables)
select
        m.sampling_uuid,
        m.sampling_name,
        TO_CHAR(m."date", 'YYYY-MM-DD"T"HH24:MI:SSZ') AS created_at,
        cp.id_lote as field_id,
        l.uuid_lote as field_uuid,
        m.zoning,
        m.analysis,
        mu.uuid as sample_set_uuid,
        cp.yeargroup,
        TO_CHAR(mu.f_usr_cierre, 'YYYY-MM-DD"T"HH24:MI:SSZ') as closed_at,
        coalesce(
            array_agg(
                json_build_object(
                    'point_uuid', mp.point_uuid,
                    'geometry', st_astext(mp.geometry),
                    'group_uuid', mp.group_uuid,
                    'created_at', TO_CHAR(mp.user_created_at, 'YYYY-MM-DD"T"HH24:MI:SSZ'),
                    'checked', mp.checked_id
                )
            ) filter (where mp.point_uuid is not null),
            array[]::json[]
        ) as points,
        m.group_assigned_id
from muestreos m
    join muestras mu on mu.id = m.id_muestra
    join ciclos_productivos cp on cp.id = mu.id_ciclos_productivos
    join lotes l on l.id = cp.id_lote
    left join muestreos_puntos mp on mp.sampling_id = m.sampling_id and mp.deleted_at is null
where
    m.sampling_uuid = %(sampling_uuid)s
    and cp.id_lote in %(field_id)s
    and m.deleted_at is null
    AND m."date" BETWEEN %(date_from)s AND COALESCE(%(date_to)s, now())
    AND cp.yeargroup = %(yeargroup)s
group by m.sampling_id, mu.id, cp.id, l.uuid_lote
Query traer valores de las variables, grupos. Trae algunos campos que no son necesarios para muestreo pero se usa la misma query para marcadores cambia los filtros
select
    id_estancia as farm_id,
    lotes.id as field_id,
    zg.id as spot_id,
    zg.group_uuid,
    zg.code,
    zg.barcode,
    gzg.shape as group_shape,
    gzg.data as group_data,
    zg.uuid,
    zg.nombre as spot_name,
    zg.f_ini as creation_ts,
    st_astext(zg.shape) as spot_shape,
    zg.area,
    zg.datos as spot_data,
    zg.id_muestra as sample_set_id,
    m.uuid as sample_set_uuid,
    tm.id as sample_set_type_id,
    tm.tipo_muestra as sample_set_type
from zonas_gestion as zg
    join lotes on zg.id_lote = lotes.id
    left join grupo_zg as gzg on gzg.id = zg.group_uuid
    left join muestras as m on m.id = zg.id_muestra
    left join tipos_muestra as tm on m.id_tipo_muestra = tm.id
where m.uuid = any( %(sample_set_uuid)s::uuid[] ) --muestras.uuid
    and zg.fecha_fin is null
Ejemplo
Hagamos un ejemplo con 3 puntos, los cuales 2 tienen el mismo grupo. Tiene 2 analisis "0-20" y "20-40", cada analisis tiene la variable "P"
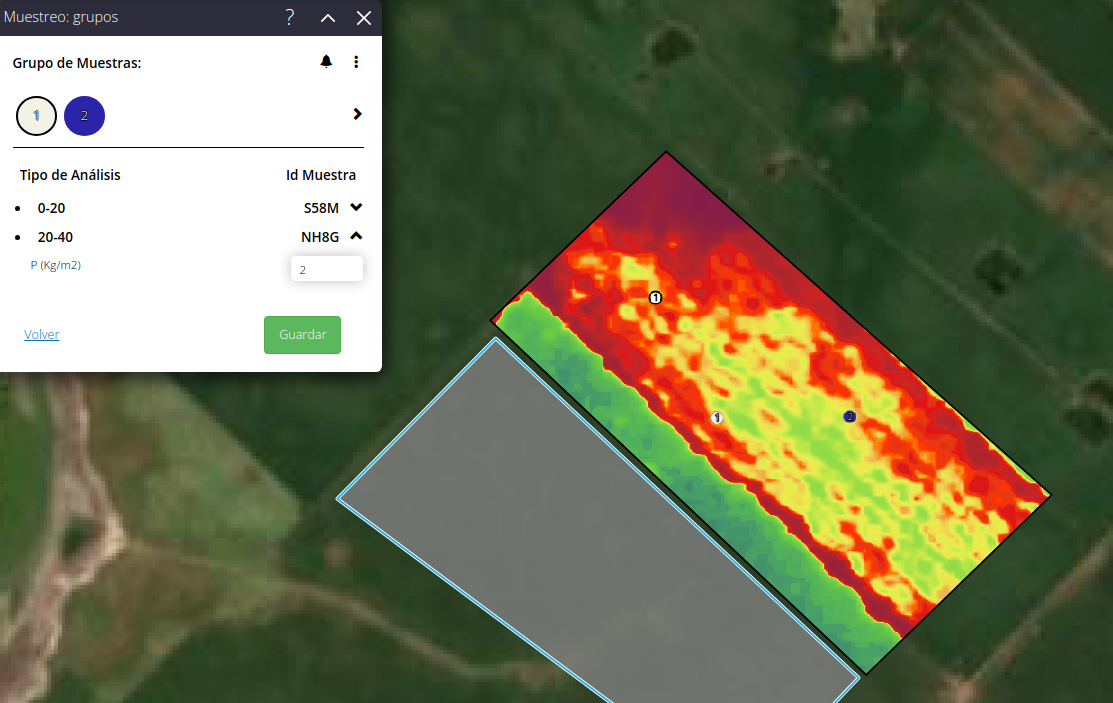
muestreos
| sampling_id | sampling_uuid | sampling_name | id_muestra | created_at | deleted_at | zoning | analysis | group_assigned_id | date | template_id |
|---|---|---|---|---|---|---|---|---|---|---|
| 1305 | 82caf528-a24e-47a2-8971-3fc2e8aa671d | grupos | 33107 | 2024-10-15 18:15:34.204 | {"info": {"date": "07 05 2024", "layer": "NDVI", "operation": "ndvi0.8", "hour": "12:10:02", "provider": "ndvi0.8"}, "type": "layer"} | {"0-20": [{"name": "P", "unit_id": 13}], "20-40": [{"name": "P", "unit_id": 6}]} | 0 | 2024-10-15 18:15:34.204 |
muestras
| id | if_tipo_muestra | id_ciclos_productivos |
|---|---|---|
| 33107 | 3 | 67002 |
muestreos_puntos
| point_uuid | geometry | sampling_id | group_uuid | checked_id |
|---|---|---|---|---|
| 626c543a-e6e2-1dbb-a6d7-793a8119b461 | POINT (-60.456723383237 -34.9465487164264) | 1305 | 4387685b-ed70-1337-8d99-b48d4a2d0f60 | 1 |
| 84f9cf8d-c38e-1b37-b8c4-495c77449184 | POINT (-60.45526903005 -34.9488938257483) | 1305 | 4387685b-ed70-1337-8d99-b48d4a2d0f60 | 1 |
| 2258c639-cfc7-1848-8d53-bb396f5e8bd5 | POINT (-60.45209806309351 -34.9488742833896) | 1305 | 30d84080-1bf4-1b5f-808f-bf5317a7278e | 1 |
grupo_zg
| id | id_muestra | data |
|---|---|---|
| 4387685b-ed70-1337-8d99-b48d4a2d0f60 | 33107 | {"sampling": {"color": "#FFFF00", "name": "1"}} |
| 30d84080-1bf4-1b5f-808f-bf5317a7278e | 33107 | {"sampling": {"color": "#FF0000", "name": "2"}} |
zonas_gestion
| id | id_lote | id_muestra | datos | uuid | group_uuid | code | barcode |
|---|---|---|---|---|---|---|---|
| 353720 | 259639 | 33107 | {"sampling": {"analysis": "0-20"}, "variables": [{"name": "P", "value": 1, "unit_id": 13}]} | 7d4a2d86-8b21-11ef-a466-0242ac100143 | 4387685b-ed70-1337-8d99-b48d4a2d0f60 | ML40-100-S58M | |
| 353721 | 259639 | 33107 | {"sampling": {"analysis": "0-20"}, "variables": [{"name": "P", "value": 3, "unit_id": 13}]} | 7d4a798a-8b21-11ef-a466-0242ac100143 | 30d84080-1bf4-1b5f-808f-bf5317a7278e | ML40-100-FQA9 | |
| 353722 | 259639 | 33107 | {"sampling": {"analysis": "20-40"}, "variables": [{"name": "P", "value": 2, "unit_id": 6}]} | 396c6aea-8b2e-11ef-8bfa-0242ac100143 | 4387685b-ed70-1337-8d99-b48d4a2d0f60 | ML40-100-NH8G | |
| 353723 | 259639 | 33107 | {"sampling": {"analysis": "20-40"}, "variables": [{"name": "P", "value": 4, "unit_id": 6}]} | 396cbb1c-8b2e-11ef-8bfa-0242ac100143 | 30d84080-1bf4-1b5f-808f-bf5317a7278e | ML40-100-1FGT |
Por cada grupo tenemos 2 zonas de gestion, Una por analisis
Templates
Son templates de analisis, en "analysis" se guarda con la misma estructura que en muestreos, agregando algunas configuraciones
Esto se guarda a nivel espacio
Al momento de crear un muestreo se copia los analisis del template, la modificacion de un analisis no afecta los muestreos creados
muestreos_variablelist
- variablelist_id
- variablelist_uuid
- list_name
- user_id
- items: es un array de json
\[{"name": $name, "value": $id }, ...\]. value es el numero que se guarda en la zona de gestion, name es el texto que tiene que ver el usuario. - workspace_id
- created_at
- deleted_at
muestreos_templates
- template_id
- template_uuid
- template_name
- user_id
- workspace_id
- created_at
- deleted_at
- analysis: la estrutura es igual a muestreos.analysis, ( key del json es el nombre del analisis, el valor es un array de
{"name": $var_name, "unit_id": $unit_id}), dentro de cada variable se puede agregar la siguiente keys:- max_value
- min_value
- list_uuid: muestreos_variablelist.variablelist_uuid, en zona de gestion "value" sera un numero que indica cual es el item de esta lista. Leer tabla muestreos_variablelist
- text: bool que indica si puede ser texto libre, si el falso solo se puede cargar number
muestreos_templates_descarga
Registra todas las descargar masiva de muestreos
- template_uuid
- file_name: para buscarlo en s3
- created_at
- deleted_at: El archivo se borra despues de X dias hasta esta fecha se podra descargar sino se tiene que generar de vuelta
- yeargroup: int filtro para buscar los muestreo de esa campaña
Otras tablas
muestreos_analisys_predefined
Sugiere nombre de analysis a la hora de crear muestreo o template
- id
- analysis (varchar)
muestreos_variables_predefined
Sugiere nombre de variables para el analisis
- id
- variable (varchar)
muestreo_variable_type_layer
Se usa para pre-cargar el tipo de capa a la hora de generar capa de muestreo.
- id
- analysis_name
- variable_name
- type_layer_id
muestreos_capas
Relaciona el muestreo-analisis-variable con las capas creadas
- sampling_layer_id (pk)
- sampling_id
- analysis: nombre del analisis
- variable: nombre de la variable
- layers_ids: array de id de capa.id
- deleted_at
Base de datos completa